Protection données Claude : le guide concret pour 2026
GRATUIT: Plus de 50 prompts IA prêts à l'emploi pour votre activité
Vous avez probablement déjà vu la scène. Un collaborateur ouvre Claude pour gagner dix minutes sur un mail tendu, colle un échange client, demande une reformulation plus diplomate, puis passe à autre chose. Le problème n'est pas l'outil. Le problème, c'est que ce geste banal déclenche des obligations très concrètes.
Sur la protection des données dans Claude, beaucoup de contenus français restent au niveau d'une seule question, « est-ce que mes données servent à entraîner le modèle ? ». C'est trop court. En pratique, vous devez séparer trois sujets différents. Le training, la localisation et la rétention. C'est cette séparation qui permet de décider vite, sans surjouer le risque et sans envoyer n'importe quoi dans un compte grand public.
Table des matières
- Ce que le RGPD exige vraiment quand on saisit une donnée dans Claude
- Choisir la bonne surface Claude avant de saisir quoi que ce soit
- Cartographier le flux de données de votre poste au serveur
- Anonymiser et pseudonymiser avant l'envoi, mode d'emploi
- DPA, zéro rétention et autres réglages à activer côté entreprise
- Trois checklists prêtes à l'emploi pour indépendants, PME et métiers sensibles
Ce que le RGPD exige vraiment quand on saisit une donnée dans Claude
Claire dirige une PME de 12 personnes. Un client menace de résilier. Elle copie sa fiche, son historique de mails et quelques notes internes dans Claude pour rédiger une réponse plus propre. Juridiquement, elle vient de lancer un traitement de données personnelles.
La CNIL rappelle que le RGPD s'applique pleinement aux usages d'IA générative. Dès qu'un collaborateur saisit un nom, un email, un dossier client ou une donnée RH dans Claude, l'entreprise entre dans le champ du règlement. Cela suppose notamment une base légale, l'information des personnes concernées, un registre des traitements et des mesures de sécurité adaptées, avec une confirmation officielle dans la quatrième recommandation IA-RGPD publiée le 5 juin 2025 selon l'analyse consacrée aux usages d'IA générative et au RGPD.
Ce que ce geste déclenche côté entreprise
Le premier réflexe utile n'est pas « est-ce que Claude est fiable ? ». C'est une question plus simple.
Question de départ : à qui appartient la donnée, et pourquoi est-ce que je l'envoie à un modèle externe ?
Ensuite, vous déroulez la logique minimale :
- Finalité claire. Reformuler un mail, résumer un dossier, préparer une réponse RH.
- Base légale identifiable. Souvent, l'intérêt légitime de l'entreprise à traiter une demande, documenter un échange ou arbitrer une situation.
- Durée de conservation à cadrer. Pas seulement chez vous. Aussi chez le fournisseur si des traces sont gardées.
- Information des personnes. Pas forcément par un roman juridique. Mais au moins par une information cohérente dans vos mentions et votre gouvernance interne.
Donnée personnelle ne veut pas dire donnée sensible
Un nom, un email professionnel, un numéro de téléphone, une appréciation sur un salarié ou un commentaire client sont déjà des données personnelles. Vous n'avez pas besoin d'être dans le médical pour entrer dans le RGPD.
Les données sensibles au sens du régime renforcé sont autre chose. Santé, éléments particulièrement intimes, informations très exposantes. Dans la pratique PME, beaucoup de gens confondent encore « confidentiel pour mon business » et « sensible au sens juridique ». Les deux peuvent se recouper. Ils ne sont pas synonymes.
Qui porte quoi entre vous et Anthropic
Votre entreprise reste le responsable de traitement. En clair, c'est vous qui décidez pourquoi la donnée part dans Claude et dans quel cadre. Le fournisseur, lui, intervient comme prestataire sur une partie de l'opération selon l'offre choisie et le contrat disponible.
Si le traitement peut présenter un risque élevé, il faut envisager une AIPD. Une AIPD, c'est une analyse d'impact relative à la protection des données. Elle sert à documenter le risque avant de généraliser un usage.
Pour aller plus loin sur l'évaluation d'un prestataire, vous pouvez aussi lire ce guide pour vérifier qu'un outil IA respecte le RGPD.
Choisir la bonne surface Claude avant de saisir quoi que ce soit
Le vrai arbitrage n'est pas « Claude ou pas Claude ». C'est quelle surface Claude pour quel type de donnée. Mélanger Claude.ai gratuit, Claude Pro, Claude for Work et l'API dans la même politique interne est une erreur classique.
Ce qui change réellement pour un DPO
Sur les usages grand public, Anthropic indique que les conversations supprimées disparaissent immédiatement de l'historique visible, puis sont effacées des systèmes de back-end dans un délai maximal de 30 jours. Si l'utilisateur autorise l'amélioration de Claude avec ses données, ces données peuvent être conservées sous forme dé-identifiée jusqu'à 5 ans. Un chat signalé peut être conservé jusqu'à 2 ans et des scores de sûreté jusqu'à 7 ans, d'après la FAQ de conservation des données de Claude.
Côté API et usages professionnels, Anthropic précise que les prompts et sorties ne sont pas conservés par défaut, mais que certains “covered models” imposent une conservation de 30 jours. La documentation indique aussi qu'un accord de zero data retention peut s'appliquer à certains comptes qualifiés, selon la documentation API et rétention des données.
Comparaison des surfaces Claude sur les 4 critères DPO
| Surface | Rétention des conversations | Entraînement des modèles | Hébergement et localisation |
|---|---|---|---|
| Claude.ai Free | Historique utilisateur, suppression back-end sous 30 jours après suppression visible | Peut servir à l'amélioration si l'option est activée | Infrastructure indiquée par défaut aux États-Unis dans les contenus d'analyse FR |
| Claude Pro | Logique proche du grand public selon le canal d'usage | Dépend des options activées | Même vigilance sur les transferts hors UE |
| Claude for Work | Dépend du compte et du cadre contractuel | À cadrer au niveau organisation | Meilleur cadre de gouvernance, mais il faut vérifier le contrat et les réglages |
| API directe ou via cloud | Prompts et sorties non conservés par défaut, sauf cas prévus, avec variantes selon le modèle et le contrat | À configurer selon l'offre et le compte | Déploiements possibles via AWS Bedrock dans des régions européennes comme Francfort, Dublin ou Paris selon cette analyse sur la sécurité des données Claude en entreprise |
La règle simple à appliquer
Voici ma recommandation, sans détour :
- Free et Pro. Pas de donnée client identifiable. Pas de dossier RH. Pas de pièce jointe contractuelle brute.
- Claude for Work. Possible pour des usages métier si le cadre documentaire et contractuel est en place.
- API publique. Anonymisation ou pseudonymisation systématique si vous n'avez pas un dispositif plus sécurisé.
- RH, juridique, santé, finance. DPA obligatoire et niveau de preuve renforcé.
Le sujet n'est pas seulement « no training ». Le sujet opérationnel, c'est aussi l'hébergement, le transfert hors UE et la rétention.
Mini arbre de décision avant d'équiper une équipe :
- La donnée identifie directement une personne ? Si oui, sortez des comptes grand public.
- Le métier manipule des dossiers RH, santé, finance ou contentieux ? Si oui, privilégiez l'API avec gouvernance stricte.
- Vous n'avez aucun DPA ni registre à jour ? Ne déployez pas l'usage à plusieurs collaborateurs.
- Vous cherchez un panorama plus large des options sécurisées ? Consultez aussi ce comparatif sur les logiciels IA sécurisés.
Cartographier le flux de données de votre poste au serveur
La plupart des PME documentent mal le trajet réel de la donnée. Pourtant, c'est là que les angles morts apparaissent. Un bon schéma de flux vaut mieux qu'une longue politique copiée sur internet.
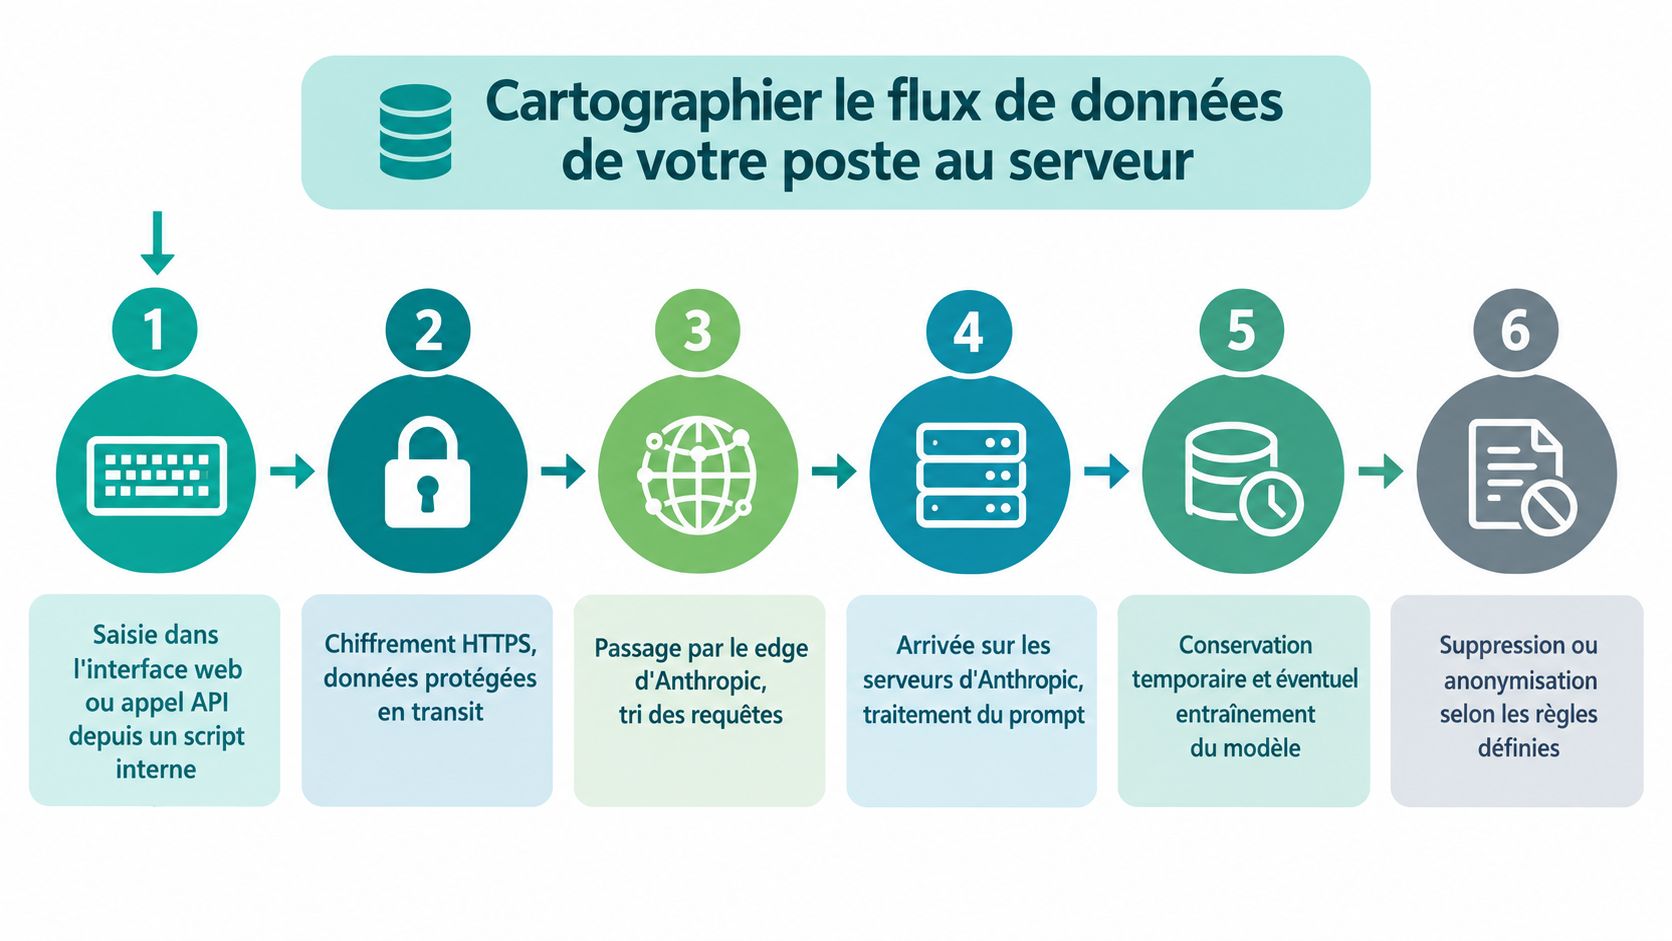
Le parcours concret d'un prompt
Prenons deux cas. Un salarié tape son texte dans l'interface web de Claude. Ou bien un script interne appelle l'API. Dans les deux cas, la donnée quitte son poste et transite vers l'infrastructure du fournisseur ou du cloud intermédiaire retenu.
Cartographiez le flux étape par étape :
- Saisie initiale dans l'interface web ou depuis un outil interne.
- Transmission chiffrée vers le service distant.
- Passage par les couches réseau et de filtrage du fournisseur.
- Traitement du prompt par le modèle.
- Persistance éventuelle dans un historique, un journal technique ou un flux de sécurité.
- Suppression, anonymisation ou conservation selon le canal et le contrat.
Les points de fuite les plus banals
Les problèmes ne viennent pas toujours du modèle lui-même. Ils viennent souvent de ce qui entoure l'usage.
- Copier-coller depuis un CRM avec nom, mobile, email et notes commerciales non masquées.
- Captures d'écran recollées dans un autre outil de travail collaboratif.
- Exports CSV préparés trop vite pour industrialiser des prompts.
- Logs internes qui rejouent les prompts dans un outil de supervision.
- Intégrations bricolées qui déplacent la donnée dans plus de systèmes que prévu.
À chaque maillon, posez toujours les trois mêmes questions. Qui voit la donnée, sous quelle forme, et pendant combien de temps ?
Le cas particulier de l'API via un cloud tiers
Quand vous passez par une couche cloud, le schéma change. Vous ajoutez votre propre environnement technique, vos droits d'accès, vos journaux et vos contrôles de chiffrement. C'est souvent plus exigeant au départ, mais beaucoup plus propre pour une PME qui veut tenir une position défendable en audit.
L'objectif n'est pas de faire un diagramme pour le plaisir. L'objectif est de pouvoir expliquer simplement à un client, à un DPO externe ou à la CNIL où circule l'information et qui garde la main à chaque étape.
Anonymiser et pseudonymiser avant l'envoi, mode d'emploi
Si vous ne pouvez pas éviter l'envoi d'éléments métier, vous devez au moins réduire la charge identifiante avant le prompt. Beaucoup d'équipes pensent anonymiser alors qu'elles pseudonymisent à moitié. La différence compte.
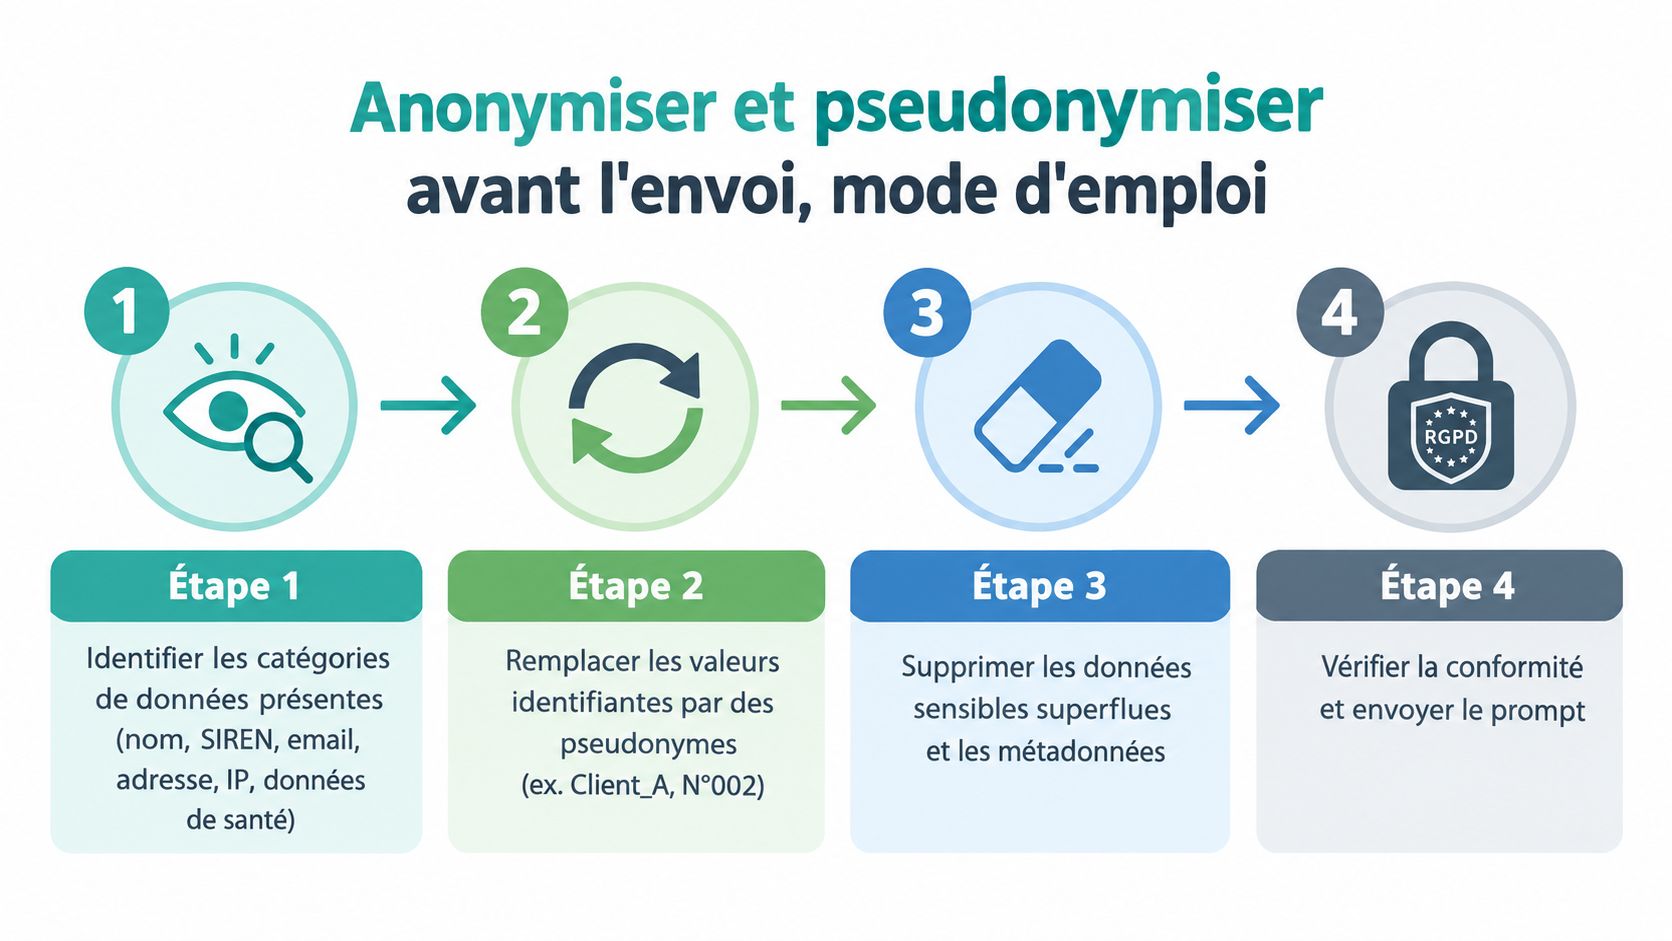
La méthode qui fonctionne en pratique
Procédez en quatre temps.
- Repérez les catégories de données. Nom, email, adresse, SIREN, identifiants de contrat, IP, données de santé, commentaires RH.
- Choisissez la bonne technique. L'anonymisation rend le retour en arrière impossible. La pseudonymisation remplace l'identifiant par un code et garde la table de correspondance chez vous, hors ligne.
- Réécrivez le prompt. Remplacez les éléments par des marqueurs comme
[CLIENT_01],[DOSSIER_RH_A],[MONTANT_HT], ou une plage de valeurs. - Recomposez localement la sortie. Le mapping se fait sur votre poste ou dans votre outil interne, pas dans Claude.
Deux exemples simples
Avant, contrat client B2B
« Reformule ce mail pour Martin Dupont de la société X, contrat signé le [date], montant [valeur], litige sur la facture [référence]. »
Après, version pseudonymisée
« Reformule ce mail pour [CLIENT_01], société [ENTREPRISE_A], contrat signé le [DATE_01], montant [MONTANT_HT], litige sur la facture [FACTURE_01]. Garde un ton ferme et commercial. »
Plus délicat, le RH.
Avant, dossier RH
« Résume cet échange avec Mme X au sujet de son arrêt, de sa reprise et de ses tensions avec son manager. »
Après, version assainie
« Résume cet échange entre [SALARIE_A] et son responsable au sujet d'une absence prolongée, d'une reprise de poste et d'un conflit managérial. Fais ressortir les faits, pas les appréciations. »
Pour un guide dédié, vous pouvez lire ce mode d'emploi sur la pseudonymisation appliquée à l'IA.
Voici aussi une démonstration utile à partager en interne avant de former les équipes :
Les limites à accepter
L'anonymisation n'est pas magique. Sur un long contrat, une consultation juridique détaillée ou un dossier RH complexe, vous perdez parfois le contexte qui fait la valeur du prompt. Dans ce cas, il faut arrêter de bricoler et basculer vers un cadre plus strict.
Un point reste constant. Même si vous anonymisez bien, cela ne dispense pas d'un DPA si l'inférence est hébergée par un tiers. Vous réduisez le risque. Vous ne supprimez pas la relation contractuelle à cadrer.
DPA, zéro rétention et autres réglages à activer côté entreprise
Une entreprise sérieuse ne se contente pas d'un paramètre de confidentialité dans un compte personnel. Elle prépare un petit socle documentaire et technique. C'est moins lourd que ce que beaucoup imaginent.
L'ordre utile pour mettre le cadre en place
Je conseille cet ordre :
- Créer un compte organisation plutôt que multiplier les comptes individuels.
- Signer le DPA et vérifier les clauses de transfert applicables.
- Choisir la surface de traitement selon la sensibilité des usages.
- Couper les options d'amélioration non souhaitées au niveau organisation quand elles existent.
- Documenter le traitement dans votre registre.
Pour les données d'organisation liées à l'API, Anthropic indique que les entrées et sorties sont automatiquement supprimées dans les 30 jours, sauf durée plus longue contrôlée par le client, accord différent comme le zéro-rétention, nécessité de faire respecter la politique d'usage, ou obligation légale. Les feedbacks et signalements associés peuvent être conservés 5 ans, selon la politique de conservation des données d'organisation.
Réglages entreprise à activer pour la conformité RGPD
| Réglage | Où | Effet RGPD |
|---|---|---|
| DPA signé | Compte entreprise et dossier fournisseur | Donne une base contractuelle exploitable avec le prestataire |
| Paramètres d'amélioration des données | Gouvernance du compte ou de l'organisation | Réduit le risque de réutilisation non souhaitée |
| Zero data retention si éligible | API et contrat associé | Réduit la persistance des prompts |
| Registre des traitements mis à jour | Documentation interne | Prouve la finalité, les catégories de données et les mesures |
| Politique d'usage interne | RH, DPO ou direction | Cadre les cas autorisés et interdits |
| Revue des sous-traitants en chaîne | Vendor management | Évite de découvrir trop tard un maillon non validé |
Les zones grises à traiter tout de suite
Un workspace partagé mal configuré peut ruiner une politique pourtant bien écrite.
Trois points reviennent sans cesse dans les audits terrain :
- Les exports CSV préparés pour gagner du temps.
- Les intégrations tierces comme des outils d'automatisation ou de messagerie qui récupèrent aussi les prompts.
- Les espaces collaboratifs où plusieurs personnes voient plus que ce qu'elles devraient voir.
Si vous utilisez des briques de gouvernance ou de formation pour cadrer les équipes, IATOLL peut faire partie de la boîte à outils côté consultants et DPO, aux côtés de vos procédures internes et de vos contrôles documentaires.
Trois checklists prêtes à l'emploi pour indépendants, PME et métiers sensibles
Les règles générales sont utiles. Les checklists le sont davantage. Imprimez celles-ci, adaptez-les, puis faites une revue régulière.
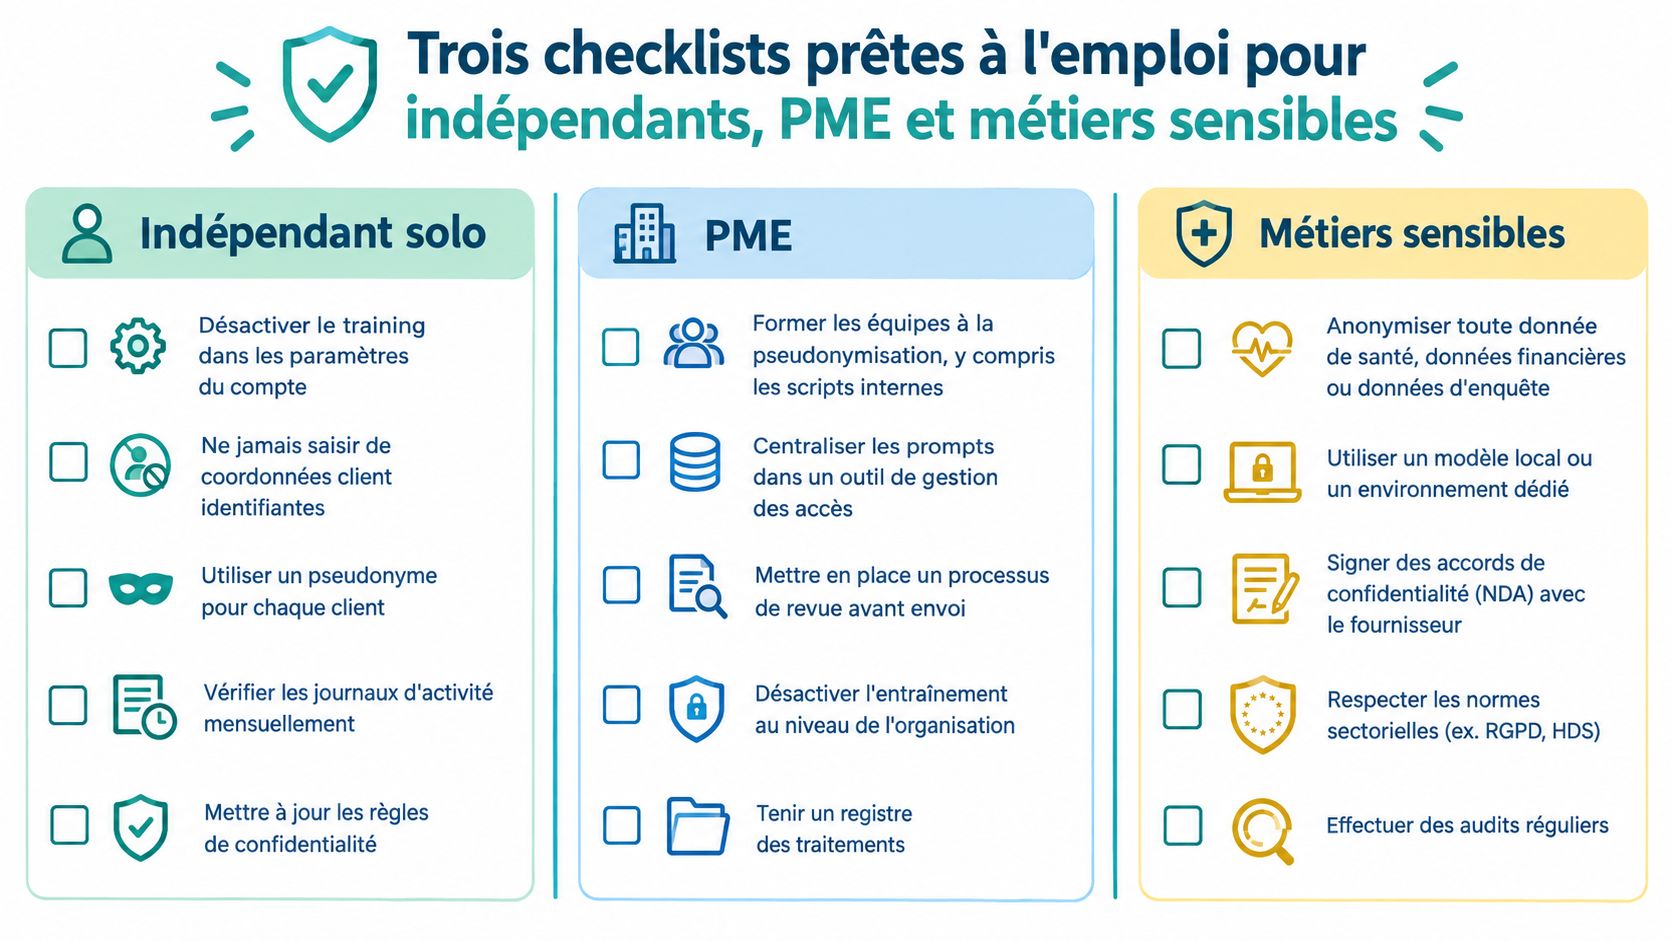
Checklist indépendant solo
N'utilisez pas Claude comme un carnet de notes client brut. C'est la règle la plus rentable à long terme.
- Désactivez les usages non nécessaires de vos données dans les paramètres disponibles sur votre compte.
- N'envoyez jamais de coordonnées client identifiantes dans un compte grand public.
- Créez un pseudonyme stable par client pour garder un contexte sans exposer l'identité.
- Nettoyez votre historique de travail selon votre routine de gouvernance interne.
- Mettez à jour votre propre politique de confidentialité si vous utilisez l'IA dans la prestation.
Maturité
- Niveau 1. Vous improvisez encore.
- Niveau 2. Vous pseudonymisez avant les cas clients.
- Niveau 3. Vous avez une méthode écrite et réutilisable.
Fréquence de revue
Mensuelle, ou dès qu'un nouveau type de dossier apparaît.
Checklist PME de 5 à 50 salariés
Ici, le sujet n'est plus seulement la confidentialité. C'est la discipline collective.
- Désignez un référent IA. Pas forcément un juriste. Quelqu'un qui tient la doctrine d'usage.
- Ouvrez un cadre entreprise au lieu de laisser chacun choisir son compte.
- Signez le DPA avant les usages RH et clients.
- Rédigez une charte courte avec une liste de prompts interdits, surtout sur les données identifiantes.
- Journalisez les cas d'usage pour savoir qui fait quoi et avec quel niveau de risque.
- Formez les équipes à la pseudonymisation, y compris celles qui automatisent via scripts internes.
Maturité
- Niveau 1. Usage dispersé.
- Niveau 2. Quelques règles existent.
- Niveau 3. Le traitement est documenté, relu et piloté.
Fréquence de revue
Trimestrielle, avec revue immédiate en cas de nouveau service ou nouveau fournisseur.
Checklist métiers sensibles
Santé, juridique, RH, finance. Là, il faut arrêter la tolérance floue.
Les politiques récentes d'Anthropic distinguent plusieurs durées selon le contexte. Un usage avec autorisation d'amélioration peut mener à une conservation jusqu'à 5 ans. Un usage sans autorisation reste sur 30 jours. Certaines entrées ou sorties liées à la sûreté peuvent être gardées jusqu'à 2 ans, et des signaux de confiance ou sécurité jusqu'à 7 ans si une conversation est signalée, d'après la version française de la FAQ sur la durée de conservation des données.
Dans ces métiers, ma position est simple :
- Basculez sur l'API avec zéro rétention si votre compte y est éligible.
- Privilégiez une exécution dans un cadre européen quand votre architecture le permet.
- Anonymisez en local avant tout envoi dès qu'un dossier touche à la santé, à une procédure RH, à un contentieux ou à des données financières.
- Interdisez certains identifiants dans les prompts, comme les données médicales brutes, les coordonnées bancaires ou les identifiants nationaux.
- Gardez une preuve de vos arbitrages en cas de contrôle, de client exigeant ou d'audit interne.
Maturité
- Niveau 1. Compte grand public encore utilisé.
- Niveau 2. API encadrée mais règles incomplètes.
- Niveau 3. Architecture, contrat, registre et formation sont alignés.
Fréquence de revue
Avant tout nouveau cas d'usage, puis à rythme rapproché tant que le dispositif n'est pas stabilisé.
IATOLL propose un écosystème de contenus et de formations dédié à l'IA sécurisée, utile quand vous devez transformer ces règles en pratiques d'équipe, en checklists et en preuves de conformité compréhensibles. Si vous êtes consultant, DPO ou dirigeant de PME, allez voir IATOLL pour structurer l'usage de l'IA sans exposer inutilement les données clients, RH ou métier.