Fuites de données IA : comprendre et prévenir les risques
Vous êtes peut-être dans cette situation ce matin. Un collaborateur a utilisé ChatGPT, Claude, Copilot ou un autre assistant pour gagner vingt minutes sur une tâche banale. Il a collé un contrat, un échange RH, une proposition commerciale ou un extrait de dossier client. Puis quelqu'un vous demande, presque par hasard, si ces données sont restées chez vous.
C'est là que le sujet devient concret. Les fuites de données IA ne concernent pas seulement les grandes entreprises, ni seulement les équipes techniques. Elles touchent d'abord les structures qui utilisent l'IA vite, utilement, mais sans cadre clair sur ce qui sort de l'organisation, qui y accède, et qui assume la responsabilité si quelque chose dérape.
Le vrai problème, en pratique, n'est pas uniquement technique. C'est la combinaison d'un usage métier très ordinaire, d'une chaîne de sous-traitance mal lue, et d'une réaction trop lente quand un incident survient.
Table des matières
- Le moment où un prompt devient une fuite
- Ce qu'on appelle vraiment une fuite de données IA
- Les causes concrètes qui exposent vos données
- Exemples et chiffres récents pour mesurer le risque
- Que faire dans les 72 heures après une fuite
- Mesures et checklist pour prévenir les fuites au quotidien
- Vers une culture IA maîtrisée avec vos consultants
Le moment où un prompt devient une fuite
Claire dirige une PME industrielle de 25 salariés. Elle n'a pas de DSI interne. Elle utilise un assistant IA comme beaucoup de dirigeants l'utilisent aujourd'hui, pour aller plus vite sur les tâches qui n'ont aucune valeur à être réécrites à la main.
Un soir, elle colle dans un prompt un contrat client pour en reformuler une clause. Elle laisse le nom du client, le montant, le calendrier de livraison et une disposition confidentielle sur les pénalités. Son raisonnement est simple. Le document ne quitte pas son écran, elle ne l'envoie pas à un concurrent, elle demande juste une reformulation.
Le lendemain, un prestataire externe lui transfère une réponse générée par le même service. Claire y reconnaît des formulations très proches, puis des éléments qui viennent clairement de son document. À ce moment-là, elle ne comprend pas ce qu'elle regarde. Son premier réflexe n'est pas juridique. C'est la stupeur.
Elle appelle son DPO externalisé. Il lui pose trois questions très directes. Quel outil a été utilisé. Quel contenu exact a été collé. Qui d'autre, en interne, utilise ce service sans procédure.
Une fuite commence souvent par un geste productif, pas par une intention malveillante.
À froid, le constat est rude. Claire n'a pas cherché à contourner une règle. Elle a juste fait ce que font beaucoup d'équipes sous pression. Copier, coller, demander un résumé, gagner du temps. Le problème, c'est que la frontière entre assistance rédactionnelle et exposition involontaire est devenue poreuse.
C'est aussi pour cela qu'un simple guide sur comment écrire un prompt efficace ne suffit pas. Un bon prompt n'est pas seulement clair et utile. Il doit aussi être sobre en données sensibles.
Ce qu'on appelle vraiment une fuite de données IA
Une fuite de données IA n'est pas seulement un serveur piraté ou un fichier volé. C'est une situation dans laquelle un système d'IA expose, mémorise, réutilise ou restitue des informations personnelles ou confidentielles de façon non maîtrisée.
Le point clé est là. Dans un usage IA, la fuite peut venir du prompt lui-même, des journaux techniques, d'une base vectorielle persistante, d'un connecteur, d'une sortie générée, ou du modèle lorsqu'il régurgite une donnée qu'il n'aurait jamais dû pouvoir restituer.
Les trois critères à regarder
Pour qualifier proprement le risque, je conseille de vérifier trois critères.
- Une personne peut être identifiée. Directement par un nom, un e-mail, un numéro de dossier, ou indirectement par un faisceau d'éléments.
- Le traitement secondaire n'a pas de base légale claire. Vous avez peut-être le droit de traiter la donnée dans votre activité. Vous n'avez pas automatiquement le droit de l'injecter dans un outil tiers.
- Les mesures de sécurité sont insuffisantes. Le RGPD impose une logique de protection adaptée. Si l'usage IA contourne vos garde-fous, le problème n'est plus théorique.
La CNIL rappelle qu’un modèle ou système d'IA peut relever du RGPD lorsqu'il mémorise des données personnelles issues de l'entraînement ou qu'il peut régurgiter ou exfiltrer ces données par des moyens raisonnablement susceptibles d'être utilisés. Dans ce cas, les obligations RGPD s'appliquent aussi au traitement lié au modèle lui-même, comme l'explique sa page sur le statut d'un modèle d'IA au regard du RGPD.
Fuite classique vs fuite de données IA
| Critère | Fuite classique | Fuite de données IA |
|---|---|---|
| Point de départ | Piratage, vol de fichier, accès non autorisé | Prompt, connecteur, mémoire de session, sortie générée |
| Visibilité | Souvent détectable par intrusion ou extraction | Parfois discrète, diffuse, tardive |
| Support concerné | Serveur, poste, messagerie, cloud | Modèle, API, base vectorielle, historique, plugin |
| Traitement des données | Stockage ou transfert | Réutilisation, inférence, restitution, réentraînement |
| Réponse interne | IT et cybersécurité | IT, métier, DPO, juridique, fournisseur IA |
La chaîne de responsabilités est le vrai point dur
Beaucoup d'entreprises cherchent “le responsable” comme s'il n'y en avait qu'un. En réalité, il faut cartographier la chaîne.
- Le concepteur du modèle crée l'architecture et certaines logiques de traitement.
- L'hébergeur porte une part du risque opérationnel et d'accès.
- Le réutilisateur injecte ses propres données dans le système.
- L'intégrateur branche l'outil à vos flux métier, CRM, support ou base documentaire.
La CNIL a annoncé des recommandations spécifiques pour clarifier ces responsabilités au regard du RGPD et rappelle qu’une base d'entraînement issue d'une fuite de données peut être manifestement illicite, comme elle l'indique dans sa page sur la sécurité du développement de l'IA.
Si vous êtes dirigeant, votre erreur n'est pas d'utiliser l'IA. Votre erreur serait de croire que le fournisseur porte toute la responsabilité à votre place.
Sur le plan de gouvernance, il faut aussi garder un point en tête. L'article 4 de l'AI Act impose depuis le 2 février 2025 une obligation de maîtrise de l'IA pour les employeurs, et le règlement devient pleinement applicable à partir du 2 août 2026, avec des contrôles et sanctions graduées rappelés par La Voix du Nord. Cette maîtrise, c'est d'abord savoir ce qu'un salarié peut ou ne peut pas coller dans un outil.
Les causes concrètes qui exposent vos données
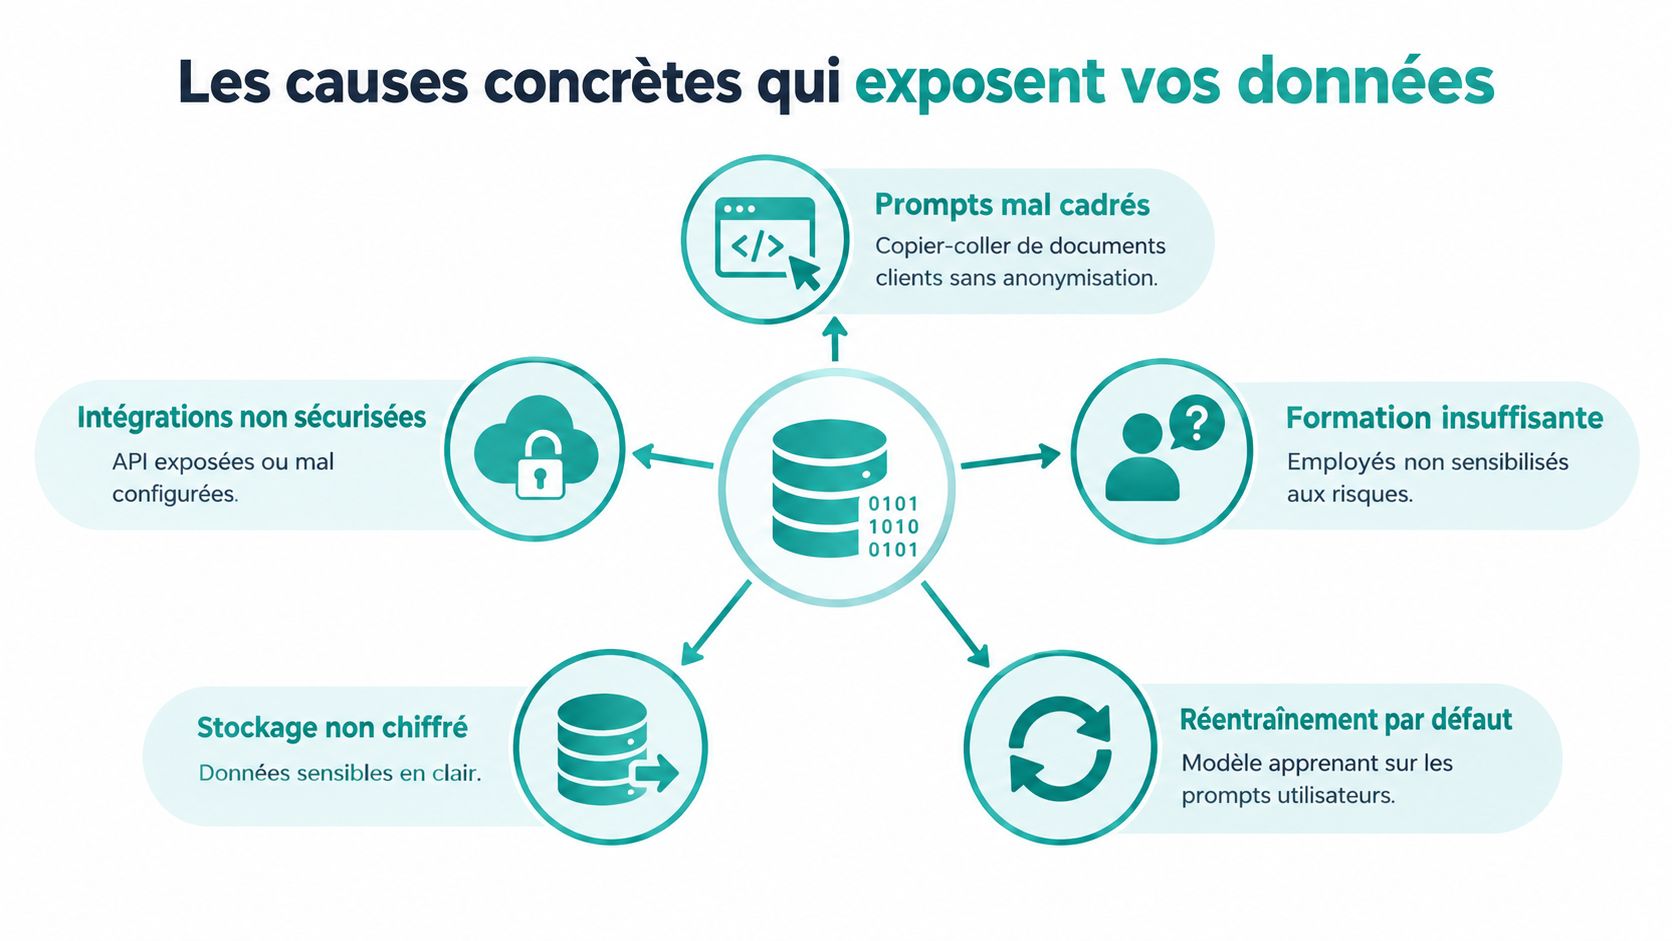
Les incidents ne viennent pas d'une seule faille spectaculaire. Dans les PME, les fuites naissent presque toujours d'un assemblage de petites décisions tolérées.
Les prompts mal cadrés
C'est le cas le plus fréquent. Un commercial colle un appel d'offres, une RH soumet un CV annoté, un juriste demande de “simplifier” une clause en laissant les noms.
Le mécanisme est simple. La donnée quitte votre périmètre de travail habituel pour entrer dans un service dont les règles de conservation, de journalisation et de réutilisation ne sont pas toujours comprises par l'utilisateur.
Le shadow AI
Le shadow AI, c'est l'usage d'outils non validés par la direction ou le DPO. Un collaborateur ouvre un compte avec son adresse pro, teste un plugin, relie sa boîte mail ou son agenda, puis l'outil devient un réflexe d'équipe avant toute validation.
Ce problème est organisationnel avant d'être technique. Si votre politique interne interdit vaguement “les usages risqués” sans lister les outils autorisés, les salariés improvisent.
La mémoire des modèles et des couches annexes
Un LLM, c'est un grand modèle de langage. Le danger, en entreprise, ne vient pas seulement du modèle principal. Il vient aussi de la mémoire de session, des historiques, des bases vectorielles utilisées pour retrouver des documents proches, et des journaux d'interaction.
En clair, même si le collaborateur croit parler dans un espace provisoire, des couches persistantes peuvent conserver des traces. C'est précisément là que naissent beaucoup de malentendus.
Les intégrations non maîtrisées
Quand un CRM, un chatbot, un formulaire ou une FAQ est connecté à une API d'IA sans contrat clair ni analyse de traitement, vous créez une sortie de données invisible pour les métiers. Le flux continue de fonctionner. Personne ne voit ce qui transite réellement.
Pour les équipes qui automatisent des réponses clients, la vraie question n'est pas seulement la qualité du texte généré. C'est aussi la nature des données que l'automatisation aspire, reformule et conserve. Sur ce point, la documentación de respuestas automáticas de Ruit donne un bon cadre de lecture sur la manière d'encadrer des réponses assistées sans perdre de vue les implications concrètes.
Les plugins et extensions
Une extension pour fureteur, un connecteur e-mail, un module de résumé de réunion, puis un autre outil de prise de notes. Chaque brique ajoute un accès supplémentaire aux conversations, pièces jointes ou contenus collés.
Voici le vrai sujet. Ces causes se cumulent.
- Un prompt trop riche passe dans un outil non validé
- Cet outil est relié à une intégration mal auditée
- Le tout repose sur une mémoire persistante
- Et une extension capte encore une copie supplémentaire
Votre RSSI ou votre prestataire IT peut très bien sécuriser l'infrastructure classique et manquer malgré tout ce circuit parallèle. Parce que l'usage IA ne ressemble pas à une fuite classique. Il ressemble à une suite de micro-dérogations tolérées.
Exemples et chiffres récents pour mesurer le risque
Lundi 9 h 12. Un commercial colle dans un assistant public un extrait de contrat pour obtenir une version plus courte avant un rendez-vous. En trois clics, une donnée client sort du circuit validé, sans instruction interne, sans base documentaire claire sur le sous-traitant, sans validation du DPO. C'est souvent à ce moment précis que le risque devient concret pour une PME.
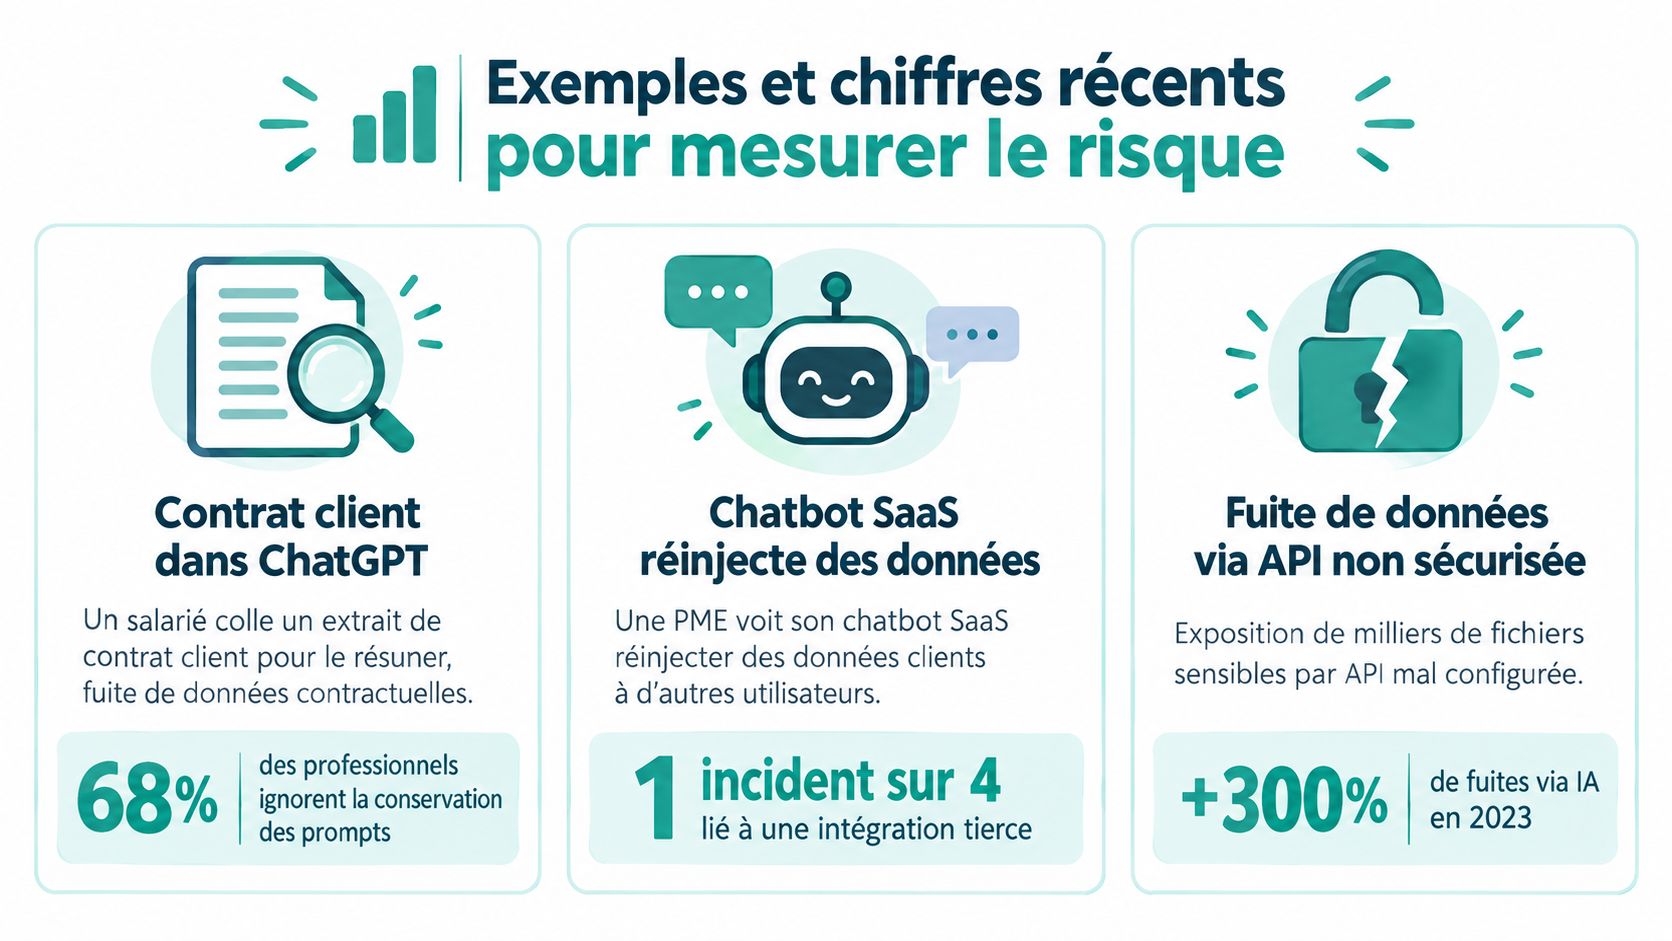
Les incidents les plus coûteux ne viennent pas toujours d'une attaque externe. Ils viennent d'un usage ordinaire, mal cadré, dans une chaîne d'acteurs mal comprise. Le concepteur du modèle, l'hébergeur, l'intégrateur du chatbot, puis votre entreprise qui réutilise l'outil n'ont pas les mêmes obligations. Si cette répartition n'est pas posée noir sur blanc, vous découvrirez les responsabilités au moment de l'incident. C'est trop tard.
Premier cas fréquent. Une PME branche un chatbot SaaS sur sa base documentaire interne. L'outil répond bien, puis restitue à un utilisateur un extrait issu d'un mauvais périmètre d'accès. Le problème n'est pas seulement technique. Il touche à la configuration des droits, au contrat de sous-traitance, à la journalisation et à la capacité de prouver qui a exposé quoi.
Deuxième cas. Une extension installée pour résumer des pages ou assister la rédaction capte plus de contenu que prévu. Des échanges commerciaux, des pièces jointes ou des données RH passent dans un service que personne n'a évalué. Là encore, le point faible n'est pas toujours le modèle. C'est souvent l'intégration périphérique.
Une fuite liée à l'IA ressemble rarement à une scène de piratage. Elle prend plus souvent la forme d'une réponse exacte, générée à partir d'une donnée qui n'aurait jamais dû entrer dans l'outil.
Les chiffres de la CNIL confirment que les violations de données restent à un niveau élevé en France. L'autorité publie chaque année ses statistiques et rappelle régulièrement que les erreurs internes, les défauts de configuration et les accès non maîtrisés restent des causes récurrentes de notification, comme l'indique la CNIL dans ses chiffres clés et bilans publics. Pour un dirigeant, le message est simple. La fuite n'est pas un cas d'école réservé aux grands groupes.
Des analyses sectorielles montrent aussi que l'IA ajoute une couche de risque très concrète chez les sous-traitants, les éditeurs SaaS et les prestataires qui manipulent des données pour le compte de leurs clients, comme le rappelle Squair Law. Retenez surtout ceci. Plus la chaîne est longue, plus la traçabilité devient difficile au moment où il faut qualifier la violation et décider d'une notification.
Autre signal utile. Les bilans relayés par Info.fr montrent un volume massif de comptes exposés en France sur des périodes récentes. Ce chiffre ne mesure pas à lui seul les fuites liées à l'IA, mais il rappelle un fait opérationnel : vos données circulent déjà dans un environnement où l'exposition est fréquente, rapide et industrialisée.
Cette courte vidéo rappelle bien pourquoi les usages les plus banals créent parfois les incidents les plus difficiles à rattraper.
La bonne décision n'est pas d'interdire tous les outils. La bonne décision consiste à attribuer les rôles, vérifier les contrats, limiter les données injectées et préparer une réponse 72 heures adaptée à une structure sans DSI. C'est ce cadre qui fait la différence entre un incident contenu et une violation mal gérée.
Que faire dans les 72 heures après une fuite
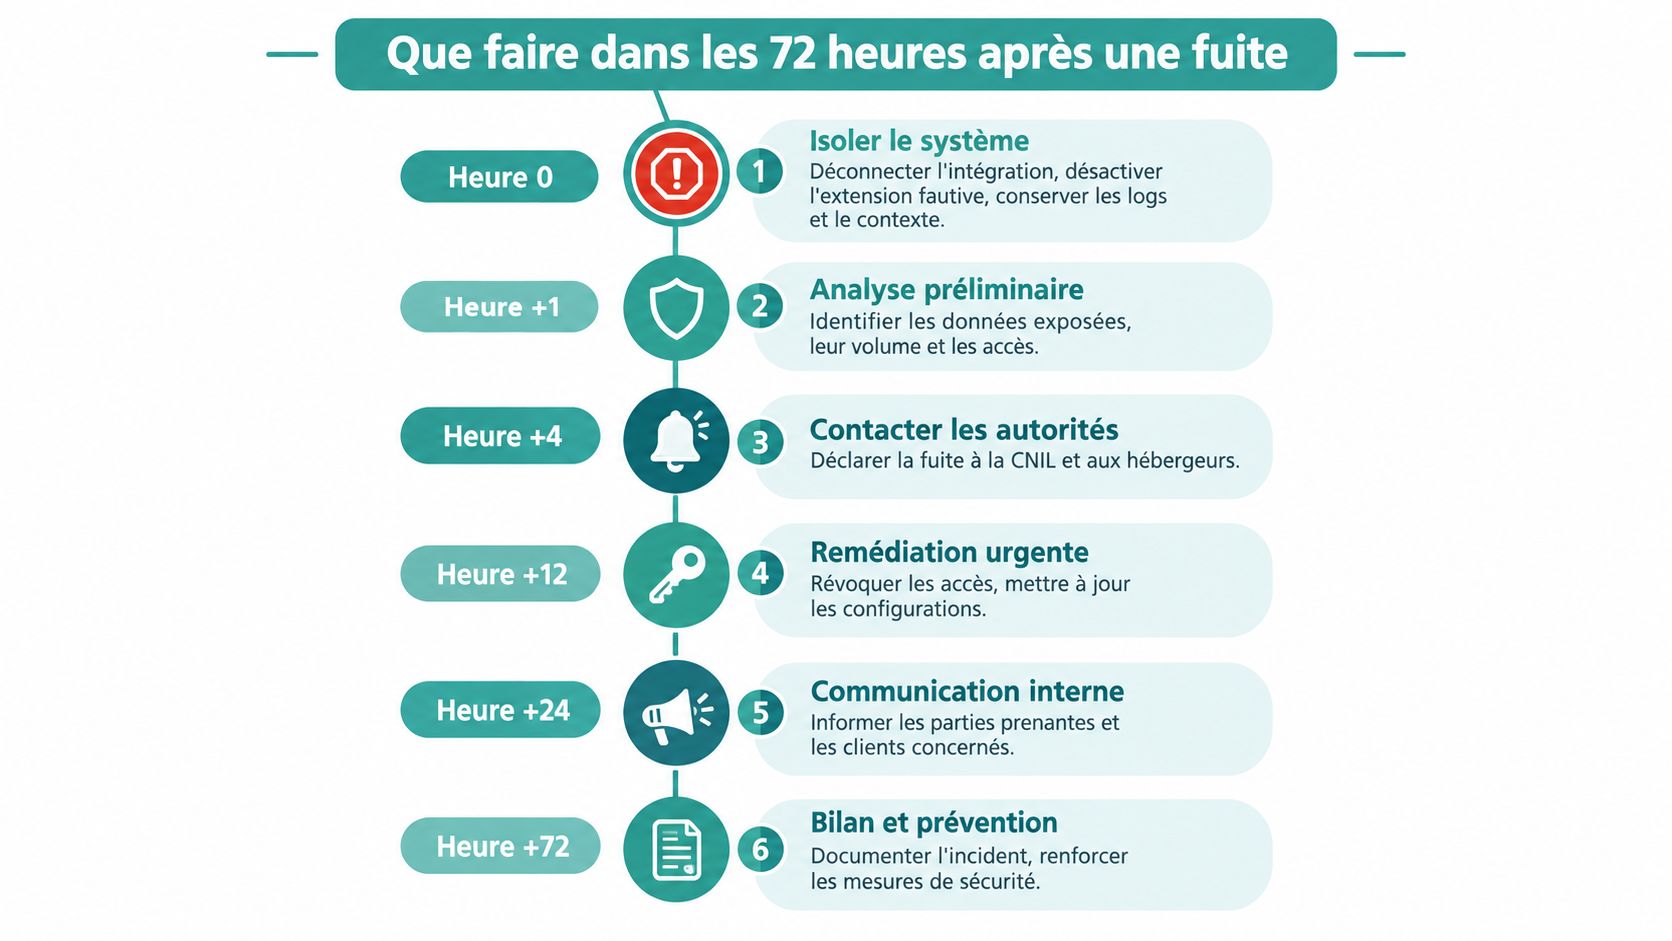
Lundi 9 h 12. Un commercial colle dans un assistant IA un extrait de contrat avec des noms, des montants et un historique d'échanges. À 11 h, vous découvrez que l'outil conserve les conversations, qu'un connecteur a synchronisé d'autres données, ou qu'un prestataire peut accéder aux logs. À partir de là, le sujet n'est plus technique. C'est une violation potentielle de données personnelles, avec un délai RGPD qui court dès que vous en avez connaissance.
La règle est simple. Le responsable de traitement doit pouvoir qualifier l'incident, documenter sa décision et, si le risque pour les personnes est plausible, notifier la CNIL dans les 72 heures. La référence utile est la page de la CNIL sur la violation de données personnelles et sa notification. Dans une chaîne IA, répartissez tout de suite les rôles. Le concepteur du modèle n'endosse pas automatiquement votre obligation. L'hébergeur exécute. L'intégrateur coupe les flux et fige les preuves. Le réutilisateur, souvent votre entreprise, reste celui qui doit décider, tracer et notifier.
Heure 0 à 4. Contenir et figer les preuves
Coupez ce qui expose encore les données. Désactivez l'extension, suspendez le connecteur, révoquez la clé API, bloquez le compte concerné, isolez le poste si nécessaire. Ne modifiez pas les journaux et ne supprimez pas l'historique avant d'avoir sécurisé les éléments de preuve.
Conservez tout de suite :
- Les prompts saisis
- Les réponses générées
- Les journaux d'accès et d'erreur
- Les captures d'écran
- La liste des comptes et prestataires ayant eu accès
- La configuration active du service, des plugins et des connecteurs
- Les contrats ou DPA applicables au fournisseur concerné
Si vous utilisez déjà des assistants dans vos équipes, ce guide sur les données dans ChatGPT en entreprise vous aide à vérifier rapidement ce qui a pu sortir, être conservé ou être réutilisé.
Heure 4 à 24. Qualifier l'incident sans usine à gaz
Dans une PME sans DSI, mon conseil est de former une cellule de crise courte, avec quatre décideurs maximum. Le dirigeant arbitre. Le DPO, interne ou externe, qualifie le risque. Le prestataire IT coupe les accès et extrait les traces. Le juriste ou l'avocat vérifie les obligations contractuelles et les notifications à prévoir.
Ensuite, remplissez une fiche de qualification. Une page suffit si elle permet de répondre aux bonnes questions.
| Élément | Question à trancher |
|---|---|
| Nature des données | Identité, paie, santé, finance, contrats, identifiants, données clients |
| Point d'entrée | Prompt, API, plugin, connecteur, base documentaire, historique |
| Acteur impliqué | Concepteur, hébergeur, intégrateur, réutilisateur |
| Personnes concernées | Salariés, clients, prospects, fournisseurs |
| Périmètre d'accès | Interne, sous-traitant, tiers non autorisé, public |
| Risque concret | Usurpation, divulgation, discrimination, préjudice financier, atteinte à la confidentialité |
Ne cherchez pas à tout comprendre avant d'agir. Cherchez à savoir si des personnes peuvent subir un préjudice et qui, dans la chaîne, détient les informations manquantes.
Heure 24 à 72. Décider, notifier, informer
À ce stade, vous devez répondre à trois questions. Y a-t-il bien une violation de données personnelles ? Le risque pour les personnes est-il plausible ? Qui notifie, sur quelle base, et avec quels éléments de preuve ?
Pour les usages IA, la difficulté vient souvent de la chaîne de responsabilités. Le fournisseur du modèle peut détenir les logs. L'hébergeur peut détenir les traces d'accès. L'intégrateur connaît les connecteurs et les réglages. Votre entreprise, si elle décide des finalités et des moyens du traitement, reste en première ligne vis-à-vis du RGPD. Exigez donc immédiatement de chaque acteur un retour écrit sur son périmètre, les données potentiellement exposées, la durée de conservation et les mesures prises.
Je recommande ce calendrier :
Avant 24 heures
Figez la chronologie, les systèmes touchés, les catégories de données et les acteurs impliqués.Avant 48 heures
Rédigez l'analyse du risque, vérifiez les clauses contractuelles, et préparez le projet de notification.Avant 72 heures
Notifiez la CNIL si le risque pour les droits et libertés est plausible. Informez les personnes concernées si le risque est élevé et si l'information peut leur permettre de se protéger.
Un point mérite d'être traité sans confusion. Une fuite IA n'est pas seulement un fichier parti au mauvais endroit. Si un modèle, un historique de conversation, un connecteur ou un espace documentaire permet d'exposer ou de reconstituer des données personnelles, vous devez raisonner comme pour toute violation de confidentialité. La qualification juridique ne dépend pas du mot "IA". Elle dépend des données, des accès et du risque.
Documentez enfin votre décision, même si vous concluez à l'absence de notification. C'est ce dossier qui vous protège en cas de contrôle, pas une explication orale a posteriori.
Mesures et checklist pour prévenir les fuites au quotidien
La prévention utile tient en un principe. Réduire ce qui sort, limiter qui y accède, et prouver ce que vous avez cadré. Le reste est secondaire.
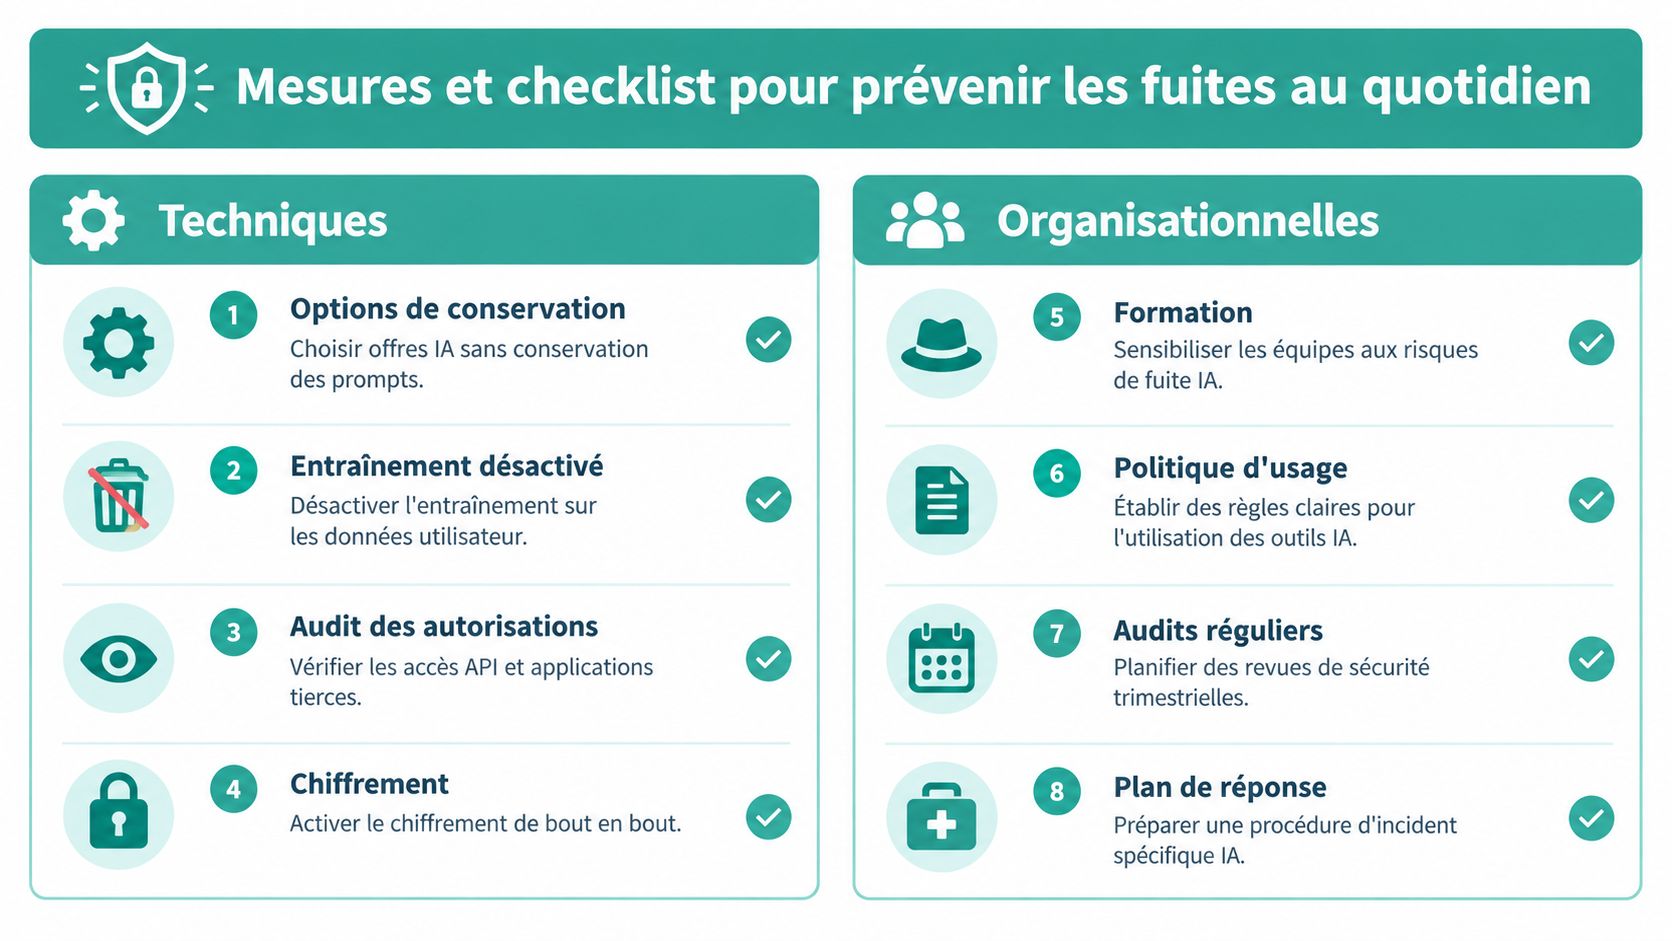
Les mesures techniques qui changent réellement le risque
Commencez par les paramètres des outils. Beaucoup d'entreprises discutent charte avant d'avoir vérifié les réglages les plus simples.
- Conservation des prompts
Choisissez des offres qui permettent d'éviter la conservation ou de la limiter fortement quand c'est possible. - Réentraînement sur vos données
Désactivez cette option si elle existe. Ne laissez jamais un réglage par défaut décider pour vous. - Comptes séparés
Évitez les comptes mutualisés. Ils brouillent les responsabilités et compliquent toute enquête. - Passerelle unique
Si vos équipes utilisent plusieurs assistants, imposez un point d'entrée validé plutôt qu'une addition d'usages libres. - Audit des connecteurs
Zapier, Make, CRM, support client, prise de notes, visio. C'est souvent là que le risque réel se niche.
Pour certaines structures, il peut être pertinent de limiter les usages à des environnements mieux cadrés ou à des solutions européennes selon la sensibilité des données. Un exemple souvent discuté est Mistral pour une IA sécurisée, à comparer avec vos contraintes métier, votre hébergement et votre politique de sous-traitance.
Les mesures organisationnelles que les PME repoussent trop longtemps
La plupart des PME n'ont pas besoin d'un grand programme. Elles ont besoin d'une doctrine écrite, courte, opposable, relue tous les trimestres.
Je recommande au minimum :
- Une charte IA interne signée
Elle dit ce qui est permis, interdit, et sous quelles conditions. - Une règle d'anonymisation avant prompt
Noms, e-mails, montants, numéros de dossier, détails médicaux ou RH. Tout ce qui peut être retiré doit l'être. - Un registre des usages IA
Pas un document théorique. Une liste vivante des outils, finalités, données injectées et responsables. - Un référent IA
Pas nécessairement un expert technique. Une personne qui centralise les questions, exceptions et incidents. - Une formation minimale des équipes
L'AI literacy, ou maîtrise de l'IA, consiste à comprendre suffisamment les usages, limites et risques pour utiliser ces outils correctement au travail.
La CNIL rappelle aussi que les outils d'IA générative reposent sur l'exploitation massive de données, souvent personnelles, et que les agents IA accroissent le risque à cause de flux opaques et d'une mémoire persistante, comme l'indique ActuaLitté. C'est précisément pour cela qu'une simple “consigne orale” ne suffit pas.
Le bon niveau de gouvernance n'est pas bureaucratique. C'est celui qui empêche un collaborateur de coller un vrai dossier client dans un outil public par habitude.
Une checklist hebdomadaire simple
Voici une base solide pour une PME ou un cabinet.
- Revoir les accès
Qui utilise quels outils IA cette semaine, avec quels droits. - Purger les historiques sensibles
Quand l'outil le permet, supprimez les conversations contenant des données métier. - Vérifier les connecteurs actifs
API, automatisations, plugins, extensions. - Tester un prompt piège
Vérifiez ce qu'un outil restitue lorsqu'on lui demande de reformuler ou de rappeler des données passées. - Mettre à jour la politique d'usage
Dès qu'un nouvel outil entre dans l'équipe. - Relire les incidents ou quasi-incidents
Une erreur rattrapée reste un signal faible à traiter. - Surveiller les fournisseurs
Changements de politique, hébergement, partage, fonctionnalités nouvelles.
Pour un indépendant, la version allégée tient en cinq points. Liste des outils utilisés. Interdiction de coller des données nominatives. Vérification mensuelle des extensions. Suppression des historiques sensibles. Relecture contractuelle des services critiques.
Dans cet écosystème, IATOLL sert de centre de ressources sur la conformité IA, les usages métier et les réflexes de sécurisation au quotidien. C'est utile quand vous devez former sans transformer chaque sujet en consultation juridique.
Vers une culture IA maîtrisée avec vos consultants
Le sujet n'est pas de faire peur aux équipes. Le sujet est de rendre les usages lisibles, gouvernables et défendables.
Dans beaucoup de PME, le consultant conformité ou le DPO externe devient le vrai relais de cette maturité. C'est logique. Il traduit l'obligation en gestes concrets, il relie le registre de traitements aux usages IA réels, et il évite que l'entreprise découvre ses outils par accident après un incident.
La CNIL a reçu 6 167 notifications de fuites en 2025, soit +10 % sur un an, et plus de 2 730 violations ont déjà été relevées sur le seul premier trimestre 2026, tandis que les contrôles cybersécurité doivent monter à 50 % des contrôles en 2026, comme le rappelle Libération. Le message est simple. L'improvisation ne tient plus comme mode de gestion.
Trois décisions suffisent souvent à faire basculer une organisation du flou vers la maîtrise.
- Nommer un référent IA
- Intégrer les usages IA dans le registre des risques RGPD
- Prévoir une revue trimestrielle des prompts sensibles, connecteurs et exceptions
Ce texte ne remplace pas un avis juridique. Il vous donne un cadre de travail. La validation finale doit rester entre les mains d'un professionnel compétent sur votre contexte, vos contrats et vos traitements.
IATOLL met à disposition des dirigeants, consultants et DPO des ressources pratiques sur l'IA sécurisée, l'AI literacy, les usages conformes et les bons réflexes de confidentialité. Si vous cherchez un point d'appui concret pour cadrer les fuites de données IA sans jargon inutile, allez voir IATOLL.


