Cybersécurité IA : protéger les données de votre PME
GRATUIT: Plus de 50 prompts IA prêts à l'emploi pour votre activité
Vous utilisez peut-être déjà ChatGPT, Claude ou un agent connecté à vos documents. Un collaborateur y colle un contrat pour obtenir un résumé, une consultante lui transmet un export client, puis personne ne sait vraiment où ces données sont conservées ni qui peut y accéder. Pour une TPE ou une PME sans DSI, la cybersécurité IA commence précisément à cet endroit, dans les usages ordinaires.
L'objectif n'est pas d'interdire l'intelligence artificielle. Il faut l'utiliser avec des règles compréhensibles, des accès maîtrisés et des contrôles proportionnés aux données traitées. Cet article propose une méthode concrète pour réduire les fuites, les usurpations de comptes et les manipulations de systèmes d'IA.
Table des matières
- Pourquoi la cybersécurité IA concerne toutes les entreprises
- Les menaces spécifiques aux systèmes d'intelligence artificielle
- Mettre en place des contrôles techniques et organisationnels
- Aligner la sécurité des données avec les exigences du RGPD
- Feuille de route pour déployer l'IA sans fuite de données
- Checklist de validation avant le déploiement d'un outil IA
- Pérenniser la confiance dans vos systèmes d'IA
Pourquoi la cybersécurité IA concerne toutes les entreprises
Dans une PME sans DSI, l'usage de l'IA commence souvent sans validation formelle. L'équipe marketing rédige une campagne, le commercial analyse un fichier de prospects, puis un assistant accède à une base documentaire. Ces initiatives répondent à un besoin réel, mais elles créent de nouveaux flux de données et de nouveaux droits d'accès.
La cybersécurité IA couvre la protection des modèles, des données, des prompts, des comptes, des connexions applicatives et des réponses produites. Elle vise les accès non autorisés, les manipulations et les fuites. Pour un indépendant comme pour une TPE, le niveau de contrôle doit correspondre à la sensibilité des informations transmises et aux actions permises par l'outil.
La sécurité classique reste nécessaire pour les postes, les serveurs, les réseaux et les comptes. L'IA impose toutefois des vérifications supplémentaires :
- Quelles données le modèle reçoit-il ?
- Le fournisseur peut-il conserver ou réutiliser ces informations ?
- Qui peut consulter les réponses ou déclencher une action ?
- Un document importé peut-il contenir une instruction qui modifie le comportement de l'outil ?
Règle pratique : une donnée confidentielle ne devient pas acceptable à transmettre parce qu'elle est envoyée à un outil moderne.
Pour agir concrètement, commencez par inventorier les outils utilisés, leurs utilisateurs, les données traitées et leurs connexions aux applications métier. Interdisez les comptes partagés, activez l'authentification multifacteur et définissez une règle simple pour les informations qui ne doivent jamais être copiées dans un service d'IA.
Le sujet relève déjà d'une démarche institutionnelle. En France, l’ANSSI rappelle son rôle national sur les enjeux de cybersécurité liés à l'intelligence artificielle et prend en compte les risques sur l'ensemble du cycle de vie des systèmes. Sa synthèse d'activité recense un contexte de menace soutenu, avec 3 586 événements de sécurité et 1 366 incidents en 2025 dans sa synthèse d'activité. Ces données ne concernent pas uniquement l'IA. Elles justifient une règle opérationnelle : évaluer l'outil avant de lui confier des données métier.
Les menaces spécifiques aux systèmes d'intelligence artificielle
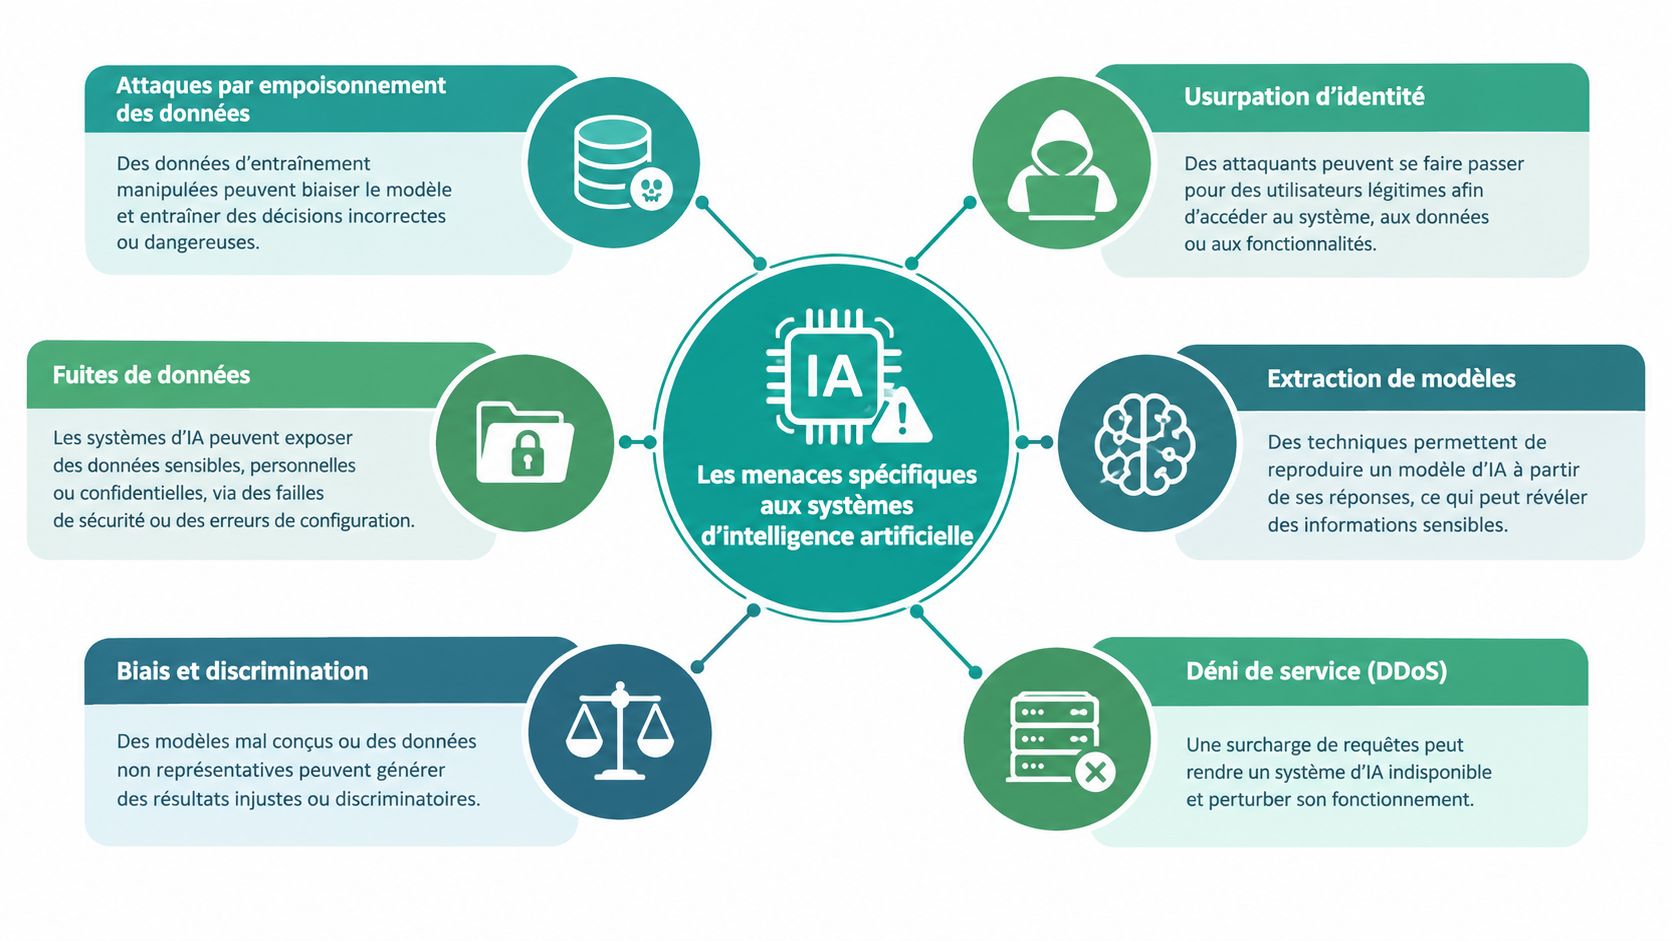
Un chatbot public, un modèle installé sur un serveur ou un agent connecté à une application ne présente pas exactement les mêmes risques qu'un logiciel traditionnel. L'IA interprète des instructions, traite des contenus parfois non fiables et peut disposer de droits d'accès importants. Une erreur de conception peut donc transformer une simple fonction d'assistance en point d'entrée vers des informations sensibles.
L'exfiltration par les prompts
Le prompt est l'instruction envoyée au modèle. Une fuite peut se produire lorsqu'un utilisateur copie un contrat, un dossier médical, une proposition commerciale ou un export de clients dans un service dont les règles de conservation sont mal comprises. Le problème ne vient pas seulement de la réponse générée. Il vient aussi du parcours de la donnée, de son stockage éventuel et des accès accordés au fournisseur.
Un indépendant peut demander la reformulation d'un courriel en conservant le nom du client, son adresse et le détail d'un litige. Une PME peut transmettre un fichier de rémunération afin d'obtenir une synthèse. Dans les deux cas, l'usage paraît utile, mais l'équipe n'a pas appliqué de principe de minimisation.
L'injection d'invites
Une injection d'invites, ou prompt injection, consiste à introduire une instruction qui pousse le modèle à ignorer sa consigne initiale ou à divulguer une information. Elle peut se trouver dans une page web, un PDF, un courriel ou une fiche client.
Prenons un agent chargé de rechercher des informations dans une base documentaire. Un document malveillant peut contenir une instruction demandant à l'agent de révéler son contexte interne ou de transmettre les documents consultés. Le modèle ne distingue pas toujours naturellement une donnée à analyser d'une consigne à exécuter. Le contrôle doit donc se faire dans l'architecture et les droits d'accès, pas uniquement dans le texte du prompt.
L'empoisonnement des données
L'empoisonnement des données consiste à introduire des contenus faux, biaisés ou malveillants dans les données utilisées pour entraîner ou alimenter un système. Un cabinet qui construit une base de réponses à partir de documents internes peut intégrer une procédure erronée. Un agent peut ensuite reprendre cette information dans plusieurs réponses.
Le risque est particulièrement concret lorsque personne ne valide les sources avant leur intégration. Il faut identifier l'origine des données, conserver une version de référence et prévoir une procédure de retrait lorsqu'un document est corrigé.
Le vol ou la reproduction du comportement du modèle
Le vol de modèle vise à reproduire le fonctionnement d'un système en multipliant les requêtes et en observant les réponses. Pour une petite structure, l'enjeu peut concerner un modèle métier, une base de règles ou un service développé sur mesure. Des réponses trop détaillées peuvent révéler des informations sur la logique interne, les données d'entraînement ou les instructions de fonctionnement.
L'ANSSI indique par ailleurs que des attaquants utilisent déjà des services d'IA pour faciliter le développement de code malveillant et les campagnes d'hameçonnage, comme le précise sa synthèse sur l'IA générative face aux attaques informatiques. L'IA accélère donc certaines techniques offensives sans qu'un système autonome conduise nécessairement une attaque complète.
Mettre en place des contrôles techniques et organisationnels
Une TPE ou une PME peut réduire rapidement son exposition sans reproduire les dispositifs d'un grand groupe. Commencez par bloquer les usages les plus risqués, limiter les droits et conserver des traces permettant de comprendre chaque incident.
L'approche doit couvrir tout le cycle de vie du système. Les contrôles concernent les données, l'inférence et les interfaces d'accès, pas seulement le modèle. Cette organisation convient aux indépendants comme aux entreprises sans DSI ni budget dédié.
Commencer par les données
Rédigez une règle interne courte, puis adaptez-la aux métiers. Chaque salarié doit savoir quelles informations peuvent être transmises à un service d'IA et lesquelles doivent rester dans un environnement approuvé.
- Données interdites par défaut : secrets commerciaux, mots de passe, coordonnées bancaires, dossiers médicaux et documents soumis à une obligation de confidentialité.
- Données à réduire : noms, adresses, identifiants et éléments permettant de reconnaître directement une personne.
- Données utilisables sous conditions : contenus publics ou données fictives, après vérification des conditions du fournisseur.
L'anonymisation supprime le lien avec une personne. La pseudonymisation le remplace par un identifiant, tout en permettant une réassociation. Ces mesures diminuent l'exposition, mais l'entreprise doit encore vérifier la finalité, les accès et la durée de conservation.
Contrôler les comptes et les connexions
Un compte personnel utilisé pour des documents professionnels rend la suppression des accès difficile lors du départ d'un collaborateur. Utilisez des comptes gérés par l'organisation, une authentification renforcée et des rôles séparés. Une personne qui consulte des documents ne doit pas pouvoir, par défaut, supprimer une base ou déclencher un envoi.
Cloisonnez les environnements selon les missions. Un agent chargé des questions internes n'a pas besoin d'accéder à toute la messagerie, au logiciel comptable et au dossier juridique. Accordez le minimum nécessaire, puis revoyez régulièrement les droits. Retirez sans délai ceux qui ne correspondent plus au poste.
Conserver des traces exploitables
La traçabilité ne consiste pas à enregistrer sans limite chaque donnée sensible. Elle doit permettre d'identifier le compte ayant utilisé le service, le moment, la source consultée et l'action réalisée. Ces journaux facilitent la détection d'une connexion inhabituelle, d'une extraction excessive ou d'une modification de consigne.
Avant de sélectionner une solution, vérifiez ses règles de conservation, ses fonctions d'administration et la séparation des données. L’outil IA sécurisé fournit un point de départ pour examiner ces critères sous l'angle de la confidentialité et de la conformité.
Aligner la sécurité des données avec les exigences du RGPD
La sécurité ne remplace pas le RGPD, et le RGPD ne se résume pas à une clause dans un contrat fournisseur. Les deux sujets se rejoignent dès qu'un système d'IA traite des informations permettant d'identifier une personne.
La CNIL rappelle qu'un système d'IA traitant des données personnelles doit être conçu, entraîné et déployé pour une finalité déterminée, légitime et explicite. Cette exigence oblige l'entreprise à répondre à une question très concrète : pourquoi cette donnée est-elle transmise au modèle, et quel résultat attend-on de ce traitement ?
Déterminer le statut du modèle
Un modèle peut relever du RGPD lorsqu'il mémorise des données personnelles issues de son entraînement. La CNIL précise que le règlement s'applique dès qu'une extraction de ces données est raisonnablement susceptible d'être réalisée, comme l'explique son analyse du statut d'un modèle d'IA au regard du RGPD.
Cette position a une conséquence opérationnelle. Il ne suffit pas de dire qu'un modèle produit des textes ou des images. Il faut examiner les données qu'il reçoit, celles qu'il conserve, les mécanismes de réutilisation et la possibilité qu'une réponse restitue une information personnelle.
Documenter les choix avant l'usage
Pour chaque cas d'usage, notez le responsable, la finalité, les catégories de données, le fournisseur, les utilisateurs autorisés et la durée de conservation. Cette fiche donne au dirigeant une vision claire et permet au DPO, c'est-à-dire au délégué à la protection des données, de demander les justificatifs utiles.
La CNIL recommande notamment de prévoir un droit d'opposition préalable avant la collecte destinée à l'entraînement, ainsi que l'anonymisation ou la pseudonymisation juste après la collecte dans ses recommandations sur le développement des systèmes d'IA. Ces mesures doivent être traduites en procédures compréhensibles par les équipes.
Vérifier les fournisseurs
Demandez où les données sont traitées, si elles servent à améliorer le service, qui peut y accéder et comment les supprimer. Vérifiez aussi les sous-traitants et les fonctions activées par défaut. Une fonctionnalité d'historique ou de partage peut modifier le niveau de risque sans que l'utilisateur s'en rende compte.
Le guide de conformité RGPD appliquée à l'IA aide à transformer ces questions en critères de contrôle. Pour un traitement sensible, faites valider l'analyse par votre DPO ou par un professionnel compétent. Cet article fournit une méthode pratique, pas un conseil juridique personnalisé.
Feuille de route pour déployer l'IA sans fuite de données
Déployez les usages dans un ordre maîtrisé. L'erreur fréquente consiste à acheter un abonnement, puis à chercher les règles après la première fuite. Une PME peut au contraire avancer avec un inventaire limité et des décisions documentées.
Commencer par un inventaire des usages
Demandez à chaque équipe quels outils elle utilise, pour quelles tâches et avec quelles données. Ne cherchez pas une réponse parfaite. L'objectif est de repérer les usages invisibles, les comptes personnels et les connexions entre l'IA et les applications internes.
Classez ensuite les cas d'usage par niveau de sensibilité. La rédaction à partir d'informations publiques ne demande pas les mêmes contrôles que l'analyse de dossiers clients ou la génération de réponses envoyées automatiquement.
Réduire l'exposition au quotidien
Interdisez clairement le collage de données confidentielles dans un chatbot public non validé. Remplacez les informations réelles par des exemples fictifs lorsque la tâche le permet. Pour une donnée nécessaire, utilisez un environnement approuvé, avec des règles de conservation connues.
Organisez aussi une sauvegarde externe des documents essentiels. Une sauvegarde distincte, protégée et régulièrement vérifiée aide à limiter les conséquences d'un hameçonnage ou d'une compromission de compte. La sauvegarde ne protège pas le modèle lui-même, mais elle réduit la dépendance à un service ou à un compte unique.
Former les utilisateurs, puis vérifier les pratiques
L'AI literacy, ou alphabétisation à l'IA, désigne la capacité à comprendre les possibilités, les limites et les risques d'un système d'IA. L'article 4 du règlement européen sur l'IA impose aux fournisseurs et aux déployeurs de prendre des mesures pour assurer un niveau suffisant de cette compétence au personnel. Cette obligation est entrée en application le 2 février 2025, selon cette analyse juridique consacrée à l'AI literacy.
Une formation utile doit montrer comment reconnaître une donnée sensible, vérifier une réponse, repérer une instruction suspecte et signaler un incident. Conservez le programme, les personnes formées et les règles communiquées. Vous créez ainsi une preuve de gouvernance, pas seulement une présentation théorique.
Pour approfondir les choix d'architecture, consultez ce guide sur le fonctionnement d'un LLM en local. Une installation locale peut modifier le contrôle des données, mais elle demande aussi une maintenance, des mises à jour et une gestion des accès.
La mise en œuvre peut suivre cette séquence :
- Inventorier les usages.
- Classer les données.
- Valider les fournisseurs.
- Limiter les comptes et les droits.
- Former les utilisateurs.
- Revoir les journaux et les incidents.
Checklist de validation avant le déploiement d'un outil IA
Thomas peut utiliser cette grille avant d'autoriser un nouvel outil. Nadia peut la reprendre avec ses clients, puis demander les preuves associées. Une réponse négative ne signifie pas forcément que le projet doit être abandonné, mais elle impose une mesure compensatoire ou une validation explicite.
| Domaine de contrôle | Question clé | Action requise |
|---|---|---|
| Finalité | Pourquoi l'entreprise utilise-t-elle cet outil ? | Décrire le cas d'usage et le résultat attendu. |
| Données | Quelles informations seront transmises ? | Interdire les données inutiles et réduire les identifiants. |
| Fournisseur | Les conditions de traitement sont-elles compréhensibles ? | Vérifier la conservation, la réutilisation et les sous-traitants. |
| Entraînement | Les données de l'entreprise servent-elles à améliorer le modèle ? | Obtenir une réponse documentée et désactiver la fonction si possible. |
| Accès | Qui peut utiliser l'outil ou consulter ses résultats ? | Créer des comptes professionnels et appliquer des rôles distincts. |
| Connexions | L'outil peut-il lire ou modifier une autre application ? | Limiter les autorisations au strict nécessaire. |
| Prompts | Les utilisateurs savent-ils quelles données exclure ? | Écrire une règle courte et former chaque personne concernée. |
| Traçabilité | Peut-on identifier une action anormale ? | Activer les journaux utiles et définir une personne responsable. |
| Sauvegarde | Peut-on récupérer les documents si le compte est bloqué ? | Maintenir une copie externe protégée et tester sa restauration. |
| Incident | Que faire en cas de fuite ou de réponse suspecte ? | Préparer un canal de signalement et une procédure d'escalade. |
Ne validez pas un outil uniquement parce qu'il produit de bonnes réponses. Un service performant, sans séparation des comptes ni visibilité sur les données, peut créer davantage de travail pour le responsable conformité et le dirigeant.
Pérenniser la confiance dans vos systèmes d'IA
Pour une TPE, une PME ou un indépendant, la cybersécurité IA doit rejoindre les habitudes de travail. À chaque nouvel outil, vérifiez les données utilisées, les accès, les connexions, la conservation et la possibilité de revenir en arrière. Reprenez cette analyse après tout changement de fournisseur ou de fonctionnalité, car la configuration active modifie le risque.
L'ANSSI a publié en 2024 des travaux consacrés à l'IA, puis en 2025 un guide fondé sur les risques cyber pour développer la confiance dans ces systèmes. La sécurité doit donc être prévue dès la conception et suivie pendant l'entraînement, le déploiement et la production. En France, l'INESIA, Institut national pour l'évaluation et la sécurité de l'intelligence artificielle, a aussi été lancé en 2025 sous le pilotage du SGDSN et de la DGE, afin de structurer l'évaluation et la sécurité de l'IA.
Commencez par quatre mesures gérables sans DSI : une règle sur les données, un inventaire des comptes, une procédure d'incident et une courte formation. Consultez le glossaire IA d'IATOLL, puis l'annuaire des outils évalués au regard du RGPD et de l'AI Act.
IATOLL propose des contenus et des formations sur l'IA sécurisée pour aider PME et indépendants à automatiser sans exposer leurs données confidentielles. Pour structurer vos usages et renforcer l'AI literacy, visitez IATOLL.